Aplicaciones vivas y contratos de resultado
Traducido del original en inglés.
Hasta ahora, buena parte del mundo digital se ha organizado en torno a la idea de una aplicación relativamente fija: especificada, construida, publicada, mantenida, parcheada y, de vez en cuando, rediseñada. Incluso cuando evoluciona de forma continua, su centro de gravedad conceptual sigue siendo a menudo una base de código que los humanos gestionan mediante intervenciones periódicas.
Una nueva clase de software podría comportarse menos como un artefacto acabado y más como un organismo guiado. El punto de partida ya no es solo una especificación de producto estática. Puede ser un contrato de resultado redactado por humanos: lo que el sistema debe lograr, qué restricciones debe respetar, qué umbral de calidad debe mantener y dentro de qué límites está autorizado a actuar.
Esto no suprime la ingeniería de software, pero cambia el lugar donde la ingeniería de software sitúa su centro de gravedad.
El contrato de resultado como origen operativo
El contrato de resultado formaliza la intención en el nivel que de verdad cuenta: resultados, restricciones, autoridad y evaluación. En lugar de prescribir a mano cada pequeño camino de implementación, el humano define lo que la aplicación debe seguir cumpliendo.
Un sistema agéntico puede entonces andamiar, iterar, probar, comparar, revisar y publicar hacia ese resultado, siempre que tenga los permisos, la observabilidad y los canales de retroalimentación necesarios. En ese modelo, la aplicación no se construye y luego se revisa de vez en cuando. Se empuja continuamente hacia el cumplimiento de su contrato.
Este es uno de los lugares donde el futuro agéntico escapa más claramente a la idea de la IA como mero asistente conversacional. Aquí, los agentes se convierten en mantenedores operativos, constructores, correctores y mediadores en evolución dentro del propio software.
Un caso concreto: la factura que debe seguir siendo válida
Tomemos una pequeña herramienta de facturación que usan autónomos franceses. Su contrato cabe en una frase: toda factura que produzca debe ser aceptada por las plataformas certificadas por el Estado por las que ahora tienen que transitar las facturas en Francia. Desde el 1 de septiembre de 2026, toda empresa en Francia debe poder recibir facturas electrónicas, y a partir del 1 de septiembre de 2027 las pequeñas empresas y los microempresarios también tendrán que emitirlas, en formatos estructurados o híbridos como Factur-X. Los usuarios de la herramienta son precisamente quienes descubrirán la obligación tarde.
Las reglas no se quedarán quietas. La Administración publica aclaraciones, las especificaciones de formato tienen nuevas versiones, las plataformas endurecen su validación y el periodo de tolerancia anunciado en el lanzamiento acabará terminando. En el modelo clásico, alguien del equipo acaba notando que algo ha cambiado, escribe un ticket y la corrección sale con la siguiente versión. Entre el cambio y la versión, las facturas se rechazan, y los usuarios son los primeros en enterarse.
En el modelo de contrato, la capa agéntica vigila las fuentes que definen la validez: los textos oficiales, las especificaciones de formato, los mensajes de rechazo que devuelven las plataformas. Una factura rechazada por un motivo que el sistema nunca ha visto es una deriva, una distancia entre el contrato y la realidad. El agente la rastrea hasta el campo o la regla en cuestión, comprueba qué flujos de facturas se ven afectados, escribe la corrección, la prueba contra el validador oficial y contra cada plantilla de factura de la que dependen los usuarios, y abre el cambio para revisión. Un humano lo aprueba, porque el contrato dice que cualquier cambio que toque reglas fiscales requiere una firma humana. La siguiente factura pasa.
Nada en ese bucle es exótico. Lo nuevo es dónde empieza: no en un ticket que alguien escribió, sino en la distancia entre lo que el sistema debía garantizar y lo que realmente hizo.
Situación actual (otoño de 2026)
Cada pieza de ese bucle existe. Ninguna está cerrada todavía en torno a un contrato.
Del lado de la construcción, desde marzo de 2026 se puede asignar una incidencia de Jira al agente de programación de GitHub Copilot (en vista previa pública): lee la incidencia y sus comentarios, plantea preguntas aclaratorias en Jira cuando lo necesita y devuelve una pull request en borrador que pasa por las reglas de revisión que el equipo ya tiene. Del lado de las operaciones, Bits AI SRE de Datadog investiga incidentes por su cuenta: formula hipótesis sobre la causa raíz y las contrasta con métricas, registros y trazas. La remediación automática, como una reversión o un cambio de feature flag, es posible dentro de los límites que define el cliente, aunque la propia Datadog recomienda que, en finanzas, el agente proponga y el humano decida.
Lo que falta es el paso anterior al ticket. En ambos casos, sigue siendo un humano quien decide que hay algo que hacer. El agente ejecuta el trabajo; todavía no lo deduce de un objetivo permanente.
Fuentes: changelog de GitHub, «GitHub Copilot coding agent for Jira is now in public preview», 5 de marzo de 2026; Datadog, anuncios de DASH 2026 (Bits AI SRE).
Anatomía de una aplicación viva
¿Qué necesita realmente el agente para esto? Menos de lo que parece. Dale cinco cosas: la propia aplicación web, una dirección de correo electrónico, un servidor Elastic, acceso al repositorio de GitHub y el derecho a reentrenar el modelo que está en el núcleo de la aplicación. Es suficiente para que la aplicación evolucione por sí sola, bajo supervisión, a través de tres bucles.
El primer bucle es técnico y pasa por Elastic. Cada petición, cada error, cada pico de latencia y cada factura rechazada acaban en los registros. El agente los lee sin parar, como lo haría un ingeniero de guardia que nunca durmiera. Detecta que los rechazos de una plataforma se dispararon tras una actualización de formato, que una página se volvió más lenta después del último despliegue, que un error solo aparece en los usuarios de un navegador concreto. Cada anomalía se convierte en una hipótesis, y cada hipótesis confirmada, en una incidencia en el repositorio.
El segundo bucle pasa por los usuarios, a través de las incidencias de GitHub y, sobre todo, del correo electrónico. Algunos usuarios abren incidencias. La mayoría se limita a escribir a la dirección de soporte, con sus propias palabras: a menudo con enfado, rara vez con precisión. El agente responde, hace la pregunta que faltaba y convierte el correo en una incidencia estructurada: qué intentó el usuario, qué pasó, qué factura. Las peticiones que en realidad son la misma queja se fusionan, de modo que una funcionalidad pedida por cuarenta autónomos con cuarenta formulaciones distintas se convierte en una sola incidencia con cuarenta voces detrás.
Los dos bucles terminan en el mismo sitio: una incidencia, luego una rama, una corrección, pruebas, una pull request y un despliegue cuando el contrato lo permite. Después, Elastic muestra si la corrección funcionó de verdad, y eso cierra el bucle.
El tercer bucle va más hondo. La herramienta se apoya en un modelo para interpretar lo que hace realmente un autónomo y decidir qué régimen de IVA se aplica y qué menciones debe llevar la factura. Cada vez que un usuario corrige una de esas elecciones, por correo o directamente en la interfaz, la corrección se convierte en un dato de entrenamiento. Cuando se han acumulado suficientes, el agente reentrena el modelo, evalúa la nueva versión con un conjunto reservado de facturas verificadas y solo la propone para producción si lo hace mejor sin romper lo que ya funcionaba. La aplicación cambia entonces no solo su código, sino su manera de entender su propio dominio. En ese punto, el modelo ya no es un producto genérico enchufado desde fuera: se ha convertido en parte de la propia lógica de negocio. Y es la única parte que un competidor no puede copiar leyendo el código: como con las presencias de la primera parte, una skill se puede descargar; los pesos, no.
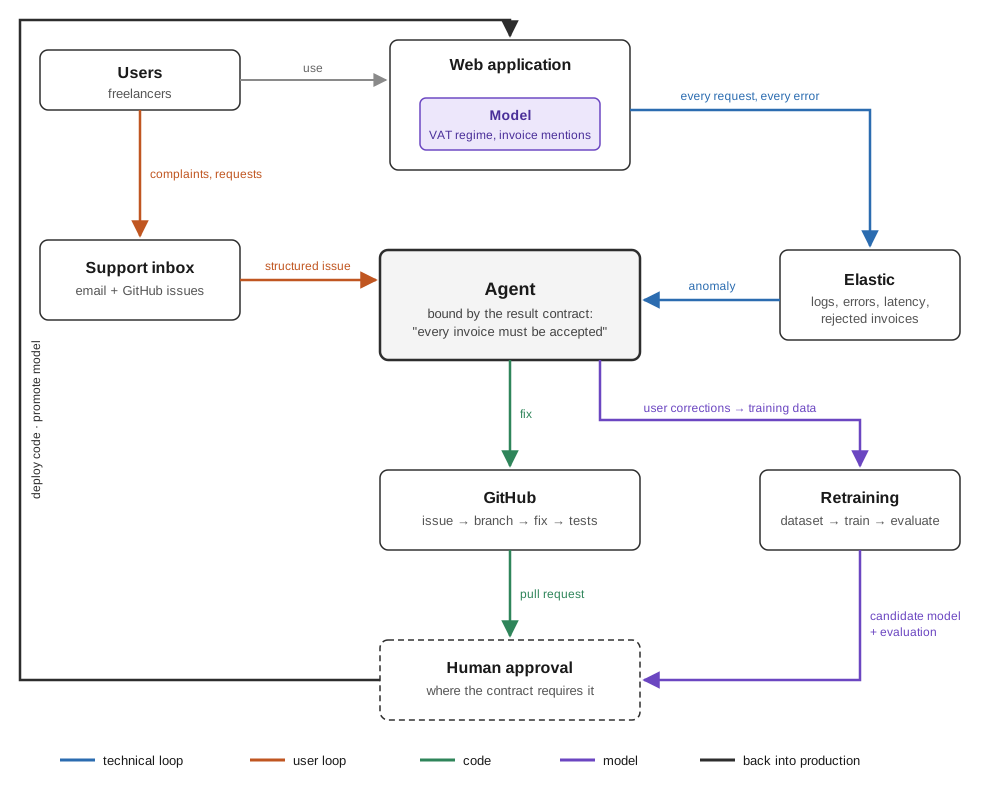
Aquí también, el contrato fija los límites: qué cambios pueden salir solos, cuáles necesitan una firma humana y qué versión del modelo está autorizada a llegar a producción.
Por eso el viejo vocabulario de la «app que se cura sola» se queda corto. No se trata solo de que el software se repare tras una avería. Se trata de que pueda ser andamiado, corregido, reorientado y llevado adelante continuamente hacia un objetivo definido por humanos.
El futuro del software como adaptación supervisada
Lo que surge de todo esto es otra imagen del software: un proceso adaptativo supervisado que avanza bajo restricciones hacia resultados definidos por humanos, un poco como hoy se «hacen crecer» los modelos de IA.
Esa podría ser una de las consecuencias más profundas de la transición agéntica. La aplicación es mantenida, corregida y desarrollada continuamente por procesos agénticos bajo gobernanza.
Queda abierta la cuestión de quién redacta ese contrato: una empresa, un equipo o, como sugiere el capítulo siguiente, los poseedores de un token.
Primera nota: agosto de 2026 · Última revisión: octubre de 2026